本文来自艾笑AI《【自媒体学 AI 必看】公众号排版 skill 详解》。
很多 Skill 写不好,不是因为提示词不够强。
而是因为一开始就没有把「流程、文件、脚本、模板」拆清楚。
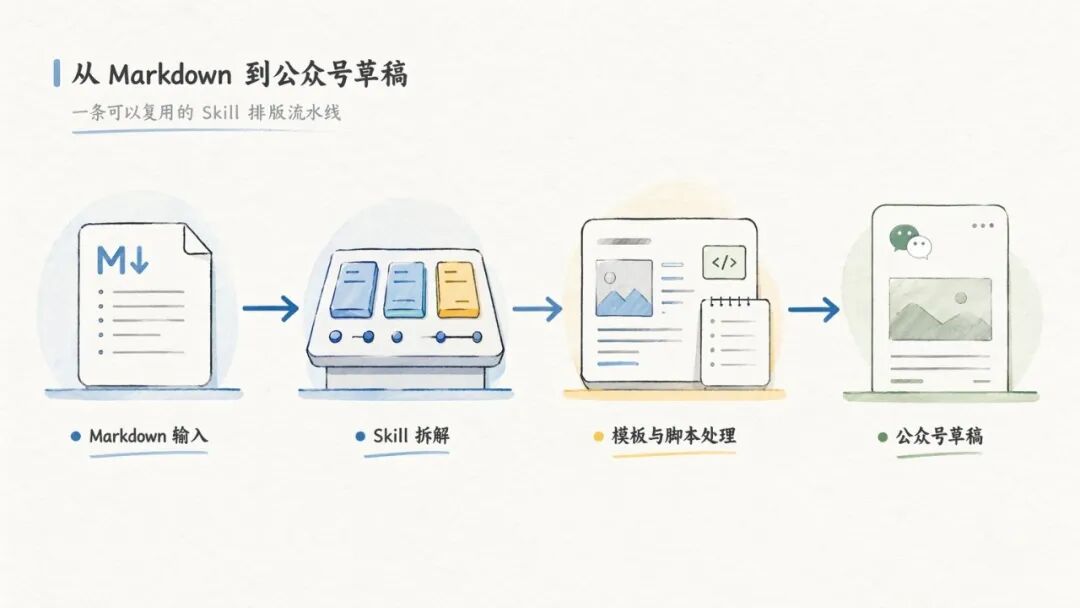
但框架讲多了,会有一个问题:听起来都对,落到手上还是不知道怎么拆。
所以今天换一个公众号排版的案例拆开来,看看这个 skill 怎么做。
公众号排版是一个常见的需求,而且在传统的工作流中也是一个费时间的事,甚至有人专门花钱请排版助理按次收费,每次 50-100元,而也有人专门就做这种自媒体小编的培训来推荐对接这种需求。
但现在这种事,一个 skill 就可以解决。原来自己排版怎么都得花个半小时,而且调整很烦人,现在只需要一句话 agent 自己完成,就像这篇文章一样,超不了一点心。
这个 skill 呢,比较适合来做一个案例。因为它不是一个简单问答,也不是一段提示词就能解决的任务。它里面有输入格式、有排版主题、有 Markdown 到 HTML 的映射、有图片处理、有预览、有校验,还有和公众号草稿同步流程的边界。
一个复杂的 Skill 能不能写好,长期好用,往往就藏在这些结构里。
01 为什么公众号排版值得做成 Skill
我平时写文章,大多先写在 Obsidian 里。源文件是 Markdown。
如果同步到布丁平台,这件事相对顺。因为布丁是我自己的平台,整条 H5 渲染链路可控:Markdown 怎么解析,图片怎么显示,代码块怎么渲染,前端可以直接配合调整。
但公众号不一样。
公众号后台不是 Markdown 编辑器。你把一篇 Markdown 长文直接复制进去,它不会自动理解这些结构:
- ## 是二级标题
- > 是引用块
- - 是列表
- ![图片] 是图片
- 代码块需要保留缩进和底色
- 表格需要在移动端还能读
公众号真正吃进去的,是一套适合它编辑器的 HTML 结构和样式。
也就是说,中间必须有一层映射关系:
Markdown 的文章语义,要被转换成微信公众号能识别、能保存、能展示的 HTML 标签。
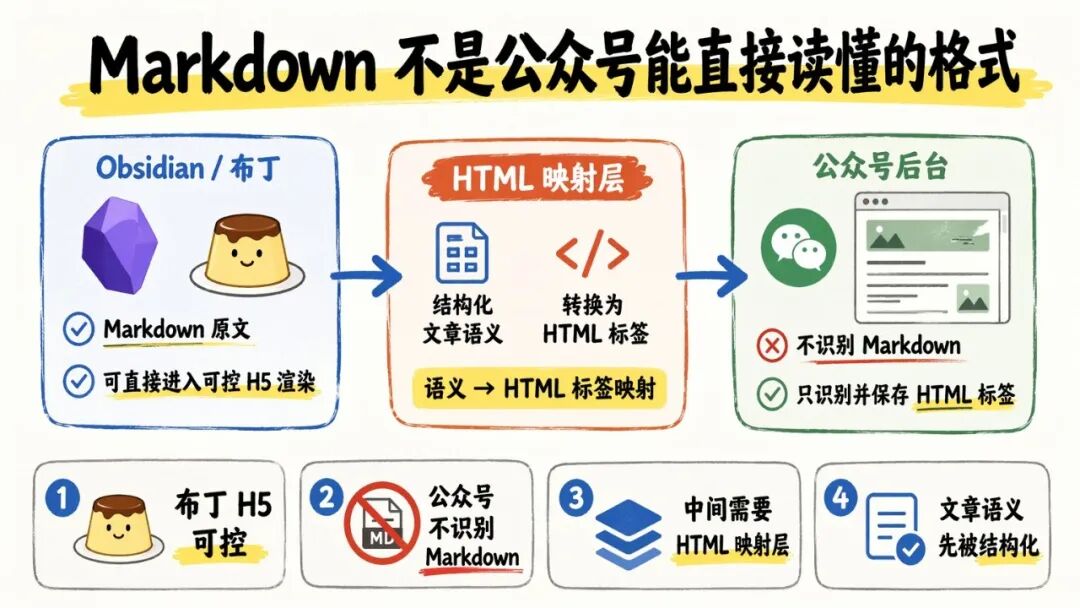
这就是公众号排版麻烦的地方。
以前常见做法是借助第三方公众号排版软件:把 Markdown 或正文粘进去,选一个主题,手动调整,再复制到公众号后台。这个流程能用,但它和自己的内容生产流水线是断开的。
每次发文都要在几个工具之间来回复制,图片还要考虑大小和上传,样式还要人工确认。文章越长、主题越多、发布越频繁,这件事越容易变成重复劳动。
所以想解决的问题不是「做一个更漂亮的模板」。
而是把公众号排版变成一个可复用的 Skill:
输入是一篇 Markdown 长文。
中间由 Skill 负责选择主题模板、加载组件、完成 Markdown 到 HTML 的映射、做微信兼容检查。
输出是一份可以预览、可以继续同步到公众号草稿的 HTML。
这个问题一旦这样定义,Skill 的结构就自然浮出来了。
02 先画出排版流水线,而不是先写提示词
很多人写 Skill 的第一反应是打开 SKILL.md,然后开始写:
「你是一个专业的公众号排版助手,请把下面的 Markdown 转成优雅的微信排版。」
这句话不能说错,但它太简单了,属于许愿式的写法,无法持续准确地完成任务。
因为公众号排版不是一句话任务,它至少要分成几步。
可以先把它画成这样:
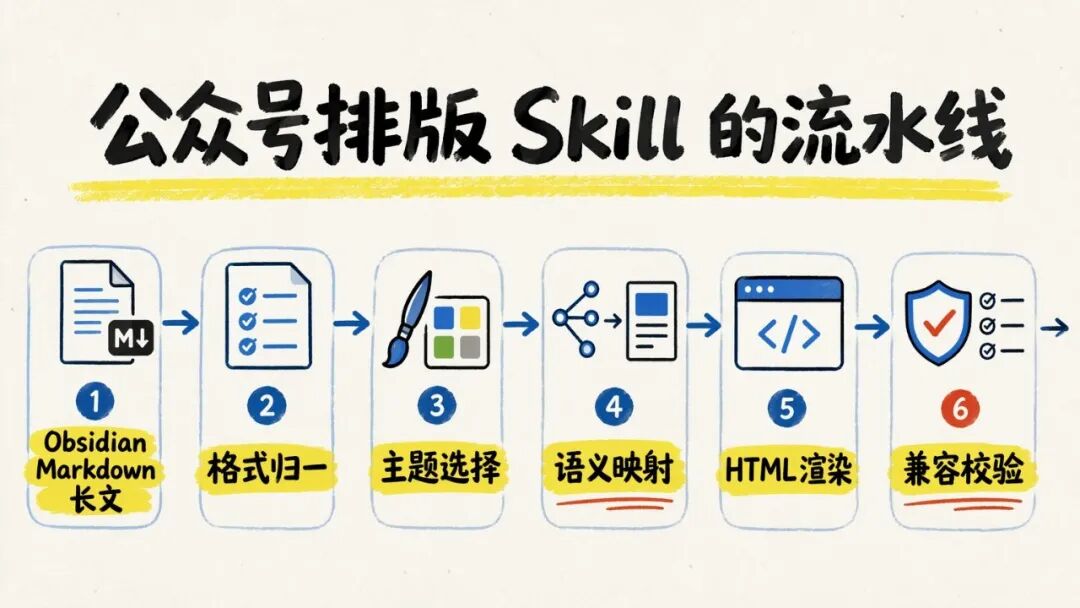
这张流程图一画出来,问题就清楚了。
SKILL.md 不应该包办所有事情,它更像整个流程的入口和调度台。
格式归一应该有说明文档。
主题选择应该有索引。
主题样式应该放在主题文件里。
HTML 渲染和校验应该尽量脚本化。
同步公众号草稿则应该交给另一个 Skill,不要塞进排版 Skill 里。
这就是 Skill 拆解的第一步:不是先问「提示词怎么写」,而是先问「这条链路有几段,每一段应该由谁负责」。
「Skill 的核心不是把一句话写得更聪明,而是让 Agent 知道下一步该读什么、该调用什么、该停在哪里。」
03 文件夹不是收纳,是职责边界
当公众号排版变成一个真正可复用的 Skill,它就不能只剩一个 SKILL.md。
它需要一个清楚的目录结构。
可以把它拆成类似这样:
text
gzh-format/
  SKILL.md
  skill.contract.yaml
  references/
    theme-index.md
    format-normalize.md
    architecture.md
    scripts.md
  themes/
    _shared/
      common-components.md
    minimal/
      components.md
    red/
      components.md
    green/
      components.md
  scripts/
    render_markdown.py
    validate_gzh_html.py
    component_lint.py
    regression.py
  assets/
    sample-article.md
  tests/
    fixtures/
      stress-markdown.md
这个目录不是为了显得工程化,也不是为了给复杂度找理由。
它的核心是把功能放到合适的位置。
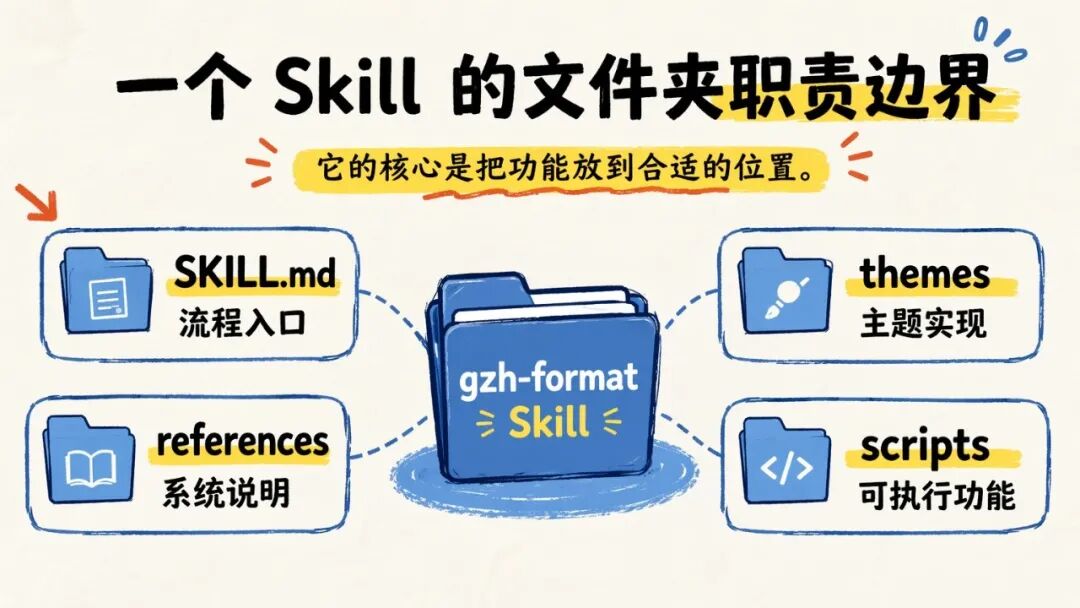
SKILL.md 负责整个流程和判断入口。
更准确一点说,它里面有两层入口。
第一层是 frontmatter 里的 description,负责让 Agent 在真正加载正文之前,就知道这个 Skill 什么时候该被触发。
第二层才是 SKILL.md 正文,负责告诉 Agent:触发之后第一步读什么,默认主题是谁,什么时候只生成预览,什么时候可以把结果交给公众号草稿同步。
references 负责说明系统怎么被理解。
这里不是随便放资料,而是放 Agent 执行时需要参考的规则。比如主题索引、格式归一、架构说明、脚本说明。
themes 负责主题实现。
不同主题的标题、引用、图片、列表、代码块可以有不同视觉风格,但它们都应该响应同一套 Markdown 语义。
scripts 负责真正可执行的功能。
渲染、校验、组件 lint、回归测试,这些都不应该靠 Agent 每次临场发挥。
assets 和 tests/fixtures 负责样例和测试输入。
一个排版 Skill 不能只拿一篇漂亮文章测试。它需要压力样稿:有长标题、有图片、有引用、有列表、有代码块、有表格。这样才能知道主题和脚本是不是真的扛得住。
所以目录结构的意义不是「收纳」。
它是在告诉自己,也是在告诉 Agent:这个系统里,每个文件夹到底承担什么职责。
04 写入口,别堆砌所有内容
很多复杂 Skill 后来变难维护,第一原因就是 SKILL.md 太重。
一开始它只是入口,后来慢慢塞进了模板、样式、脚本说明、主题规则、历史变更、异常处理,最后变成一个什么都写、什么都不清楚的大文档。
我现在更愿意把 SKILL.md 当成主控台。
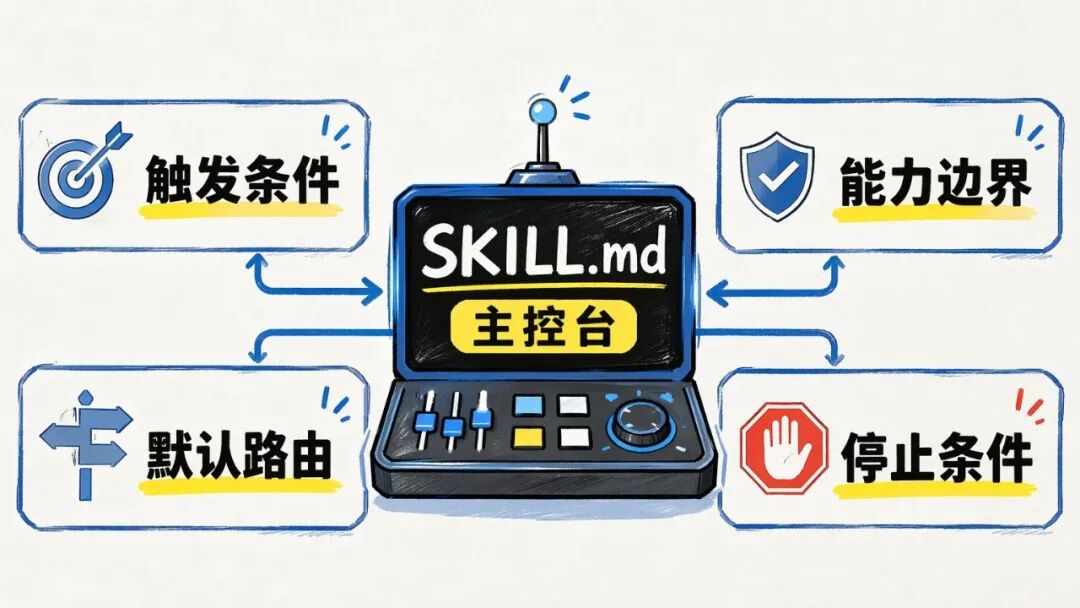
这里还有一个很容易被忽略的细节:Skill 的触发,并不是先读取 SKILL.md 正文。
对于 Agent 来说,第一眼看到的是 frontmatter 里的 name 和 description。
也就是说,description 不是装饰性的摘要,而是第一层路由规则。
它决定了 Agent 在用户说「公众号排版」「Markdown 转 HTML」「生成 H5 预览」时,会不会想到这个 Skill。要会把 description 当成触发合同来写。
一个足够干净的 SKILL.md,可以长这样:
---
name: gzh-format
description: 当用户需要公众号排版、微信排版、把 Markdown/OB 长文转成公众号 HTML、生成布丁 H5 排版、生成预览或维护排版主题时使用。这个 Skill 只负责排版、预览和校验;公众号草稿同步交给 wechat-draft-sync,布丁同步交给 pudding CLI。
---

# gzh-format

## 使用场景

- 把 Markdown 长文转成公众号 HTML
- 生成本地预览
- 为公众号草稿同步准备排版产物

## 资源分层

- references/theme-index: 主题路由表和默认选择规则
- skill.contract.yaml:机器可审契约,声明输入、输出、停止点、脚本
- theme/<theme-id>/components.md: 每套模板自己的设计变量、组件、骨架、映射
……

## 工作流

1. 识别输入:读取输入 Markdown
2. 读取主题索引:读 reference/theme-inde.md;没有指定时默认主题是XX
3. 加载主题组件:读common-components.md
4. 调用渲染脚本:根据组件映射规则调用 render_markdown.py渲染脚本
5. 调用校验脚本:用 validate-html.py 脚本进行校验
6. 输出预览或交给下游同步

## 边界

- 不写稿
- 不改事实
- 不直接发布
- 不管理公众号凭证
这段不是完整文件,是通过一个结构展示一个原则:
SKILL.md 要短,要清楚,要像入口。
它不要把整个世界都写进去。
05 写系统说明,不只是补充资料
references 很容易被误解成「资料夹」。
但在复杂 Skill 里,它其实是 Agent 的阅读路径。
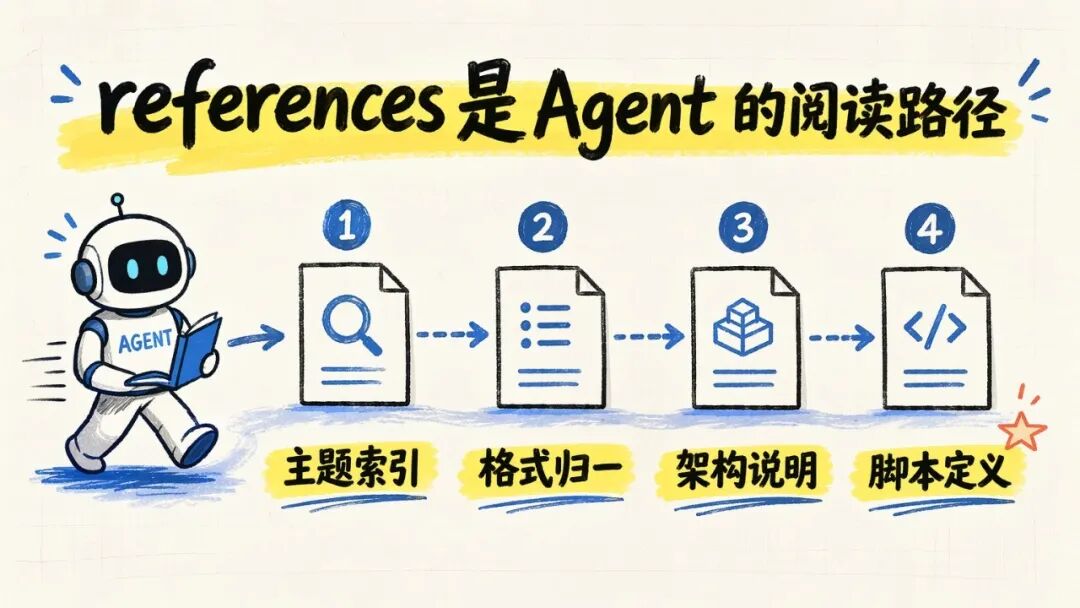
它解决的不是「多放点背景资料」,而是这几个问题。
第一,索引文档。
比如 theme-index.md 要告诉 Agent:现在有哪些主题,每个主题叫什么,适合什么场景,主题文件在哪里,默认主题是谁。
一个简化例子可以这样写:
| id | 名称 | 适合场景 | 组件文件 |
|---|---|---|---|
| minimal | 简约 | 教程、方法论、长文、年轻审美 | themes/minimal/components.md |
| red | 红色 | 观点、警示、强情绪标题 | themes/red/components.md |
| green | 绿色 | 轻松、愉悦、松弛、健康、老年审美 | themes/green/components.md |
第二,格式化与架构。
format-normalize.md 要说明:Markdown 输入里哪些结构需要先归一。比如 H1 怎么处理,图片路径怎么处理,连续空行怎么处理,代码块和表格怎么保留。
architecture.md 要说明:这个 Skill 的整体分层是什么,SKILL.md、references、themes、scripts 分别负责什么,哪些能力可以扩展,哪些边界不能越过。
第三,主题实现。
主题模板不只是颜色。一个主题至少要回答:标题怎么处理,引用怎么处理,图片怎么处理,列表怎么处理,代码块怎么处理,结尾引导怎么处理。
如果有共享组件,也要讲清楚哪些东西放在 _shared,哪些东西留给单个主题覆盖。
第四,脚本定义。
Agent 不能只知道「有脚本」,它还要知道每个脚本做什么,输入是什么,输出是什么,失败时应该怎么处理。
比如:
render_markdown.py

- 输入:Markdown 文件、主题 id、输出目录
- 输出:公众号 HTML、预览 HTML
- 失败:主题不存在、组件文件缺失、Markdown 解析失败

validate_gzh_html.py

- 输入:HTML 文件
- 输出:校验报告
- 失败:不支持的标签、图片路径异常、结构为空
这样写完以后,Agent 不是靠猜来执行,而是沿着 references 里的说明逐步推进。
这就是 references 的价值。
它让 Skill 的知识有地方放,也让主入口保持轻。
06 写功能,尤其写确定性功能
scripts 的目标不是「显得专业」。
它的目标是完成那些必须稳定执行的功能。
公众号排版里,有些事情不能每次交给 Agent 现场发挥。
- 比如 Markdown 到 HTML 的基础转换。
- 比如图片尺寸检查。
- 比如组件格式检查。
- 比如 HTML 标签白名单校验。
- 比如一篇压力样稿的回归测试。
这些任务有一个共同特点:同样输入,应该得到同样输出。
这类事情就适合写成脚本。
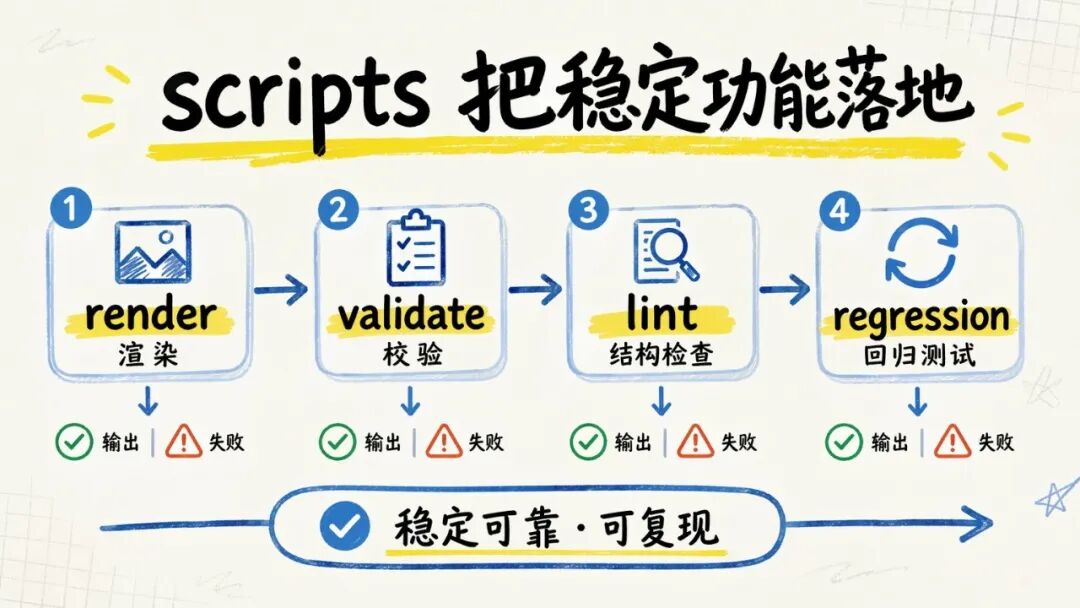
一个脚本定义可以很朴素:
python3 scripts/render_markdown.py \
  --input article.md \
  --theme minimal \
  --output /tmp/gzh-format
关键不是这条命令有多复杂。
关键是它把「渲染」这件事从自然语言里拿了出来,变成了可重复调用、可检查结果、可失败退出的动作。
如果渲染失败,脚本就应该失败。
如果校验不通过,脚本就应该明确告诉 Agent:不要继续同步公众号草稿。
这也是为什么复杂 Skill 不能只靠提示词。
提示词可以指导判断,但脚本负责把功能落地。
07 多主题项目的关键,不是多写几套模板
公众号排版项目最容易踩的坑,是把「多主题」理解成「复制几份模板」。
一开始这样最快。
但第二次迭代就会痛。
比如你想统一调整图片边距。简约主题改了,红色主题忘了,绿色主题还留着旧写法。
你想去掉章节分隔线。一个主题里在标题组件里,一个主题里在段落组件里,还有一个主题直接写在整篇 skeleton 里。
你想统一列表样式。结果发现每个主题都自己发明了一套列表结构。
这时你就会发现,多主题真正难的不是写出三套样式。
而是让三套样式共享同一套结构语言。
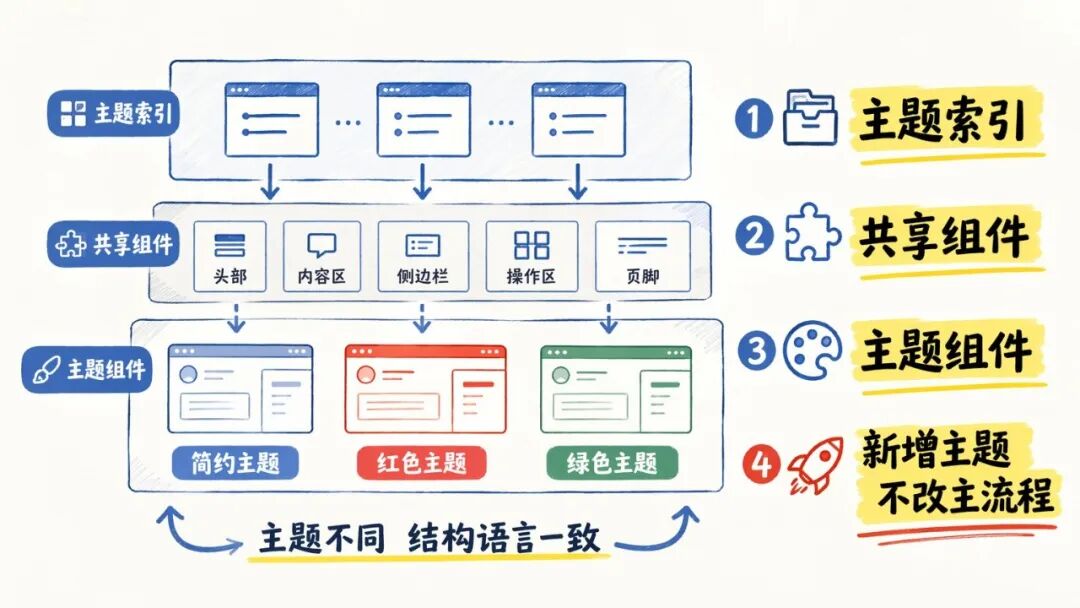
「模板不是越多越强,真正决定扩展性的,是它们有没有共享同一套文章语义。」
我会把多主题拆成三层。
第一层是主题索引。
它回答有哪些主题、默认主题是谁、每个主题入口在哪里。
第二层是共享组件。
比如段落、图片、引用、列表、表格、代码块,这些结构在所有主题里都存在。它们可以长得不一样,但语义要一致。
第三层是主题组件。
简约可以更克制,红色可以更强调,绿色可以更像手记,但它们都应该接收同一套 Markdown 语义。
新增主题时,理想动作应该是:
- 新增主题目录。
- 补主题组件。
- 在主题索引注册。
- 跑组件 lint。
- 跑回归预览。
如果每新增一个主题都要改主流程,说明这个 Skill 的抽象还不够稳。
08 组件化是结构化思维,建立各自映射关系
排版 Skill 的组件化,不是把 HTML 切成几个片段那么简单。
它真正要建立的是「Markdown 语义 -> 公众号组件」的映射关系。
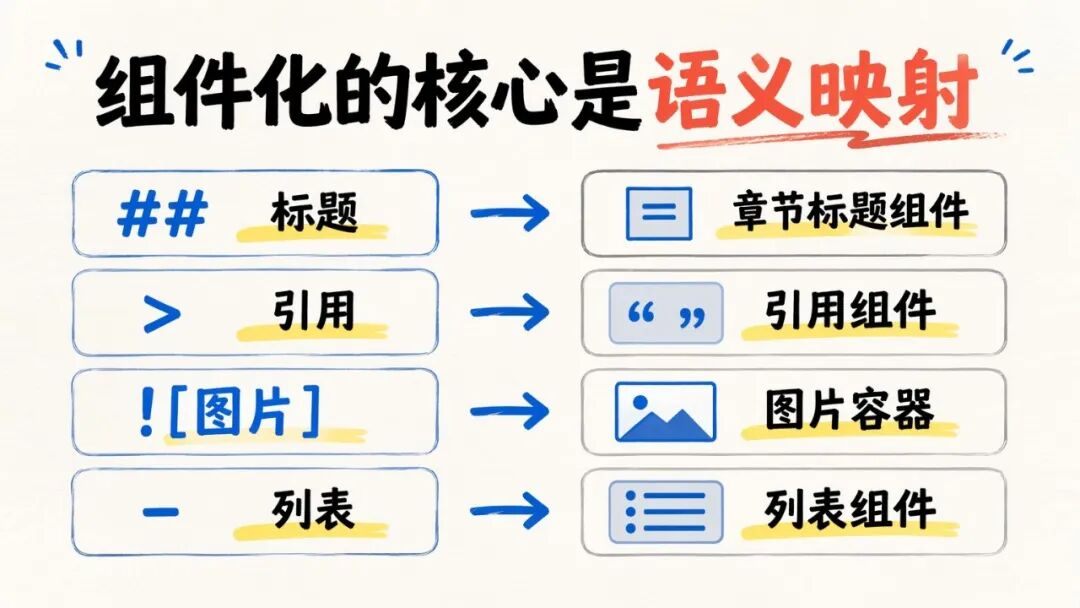
比如:
- ## 标题 -> 章节标题组件
- 普通段落 -> 正文段落组件
- > 引用 -> 引言或引用组件
- ![图片] -> 图片容器组件
- - 列表 -> 列表组件
- 代码块 -> 代码展示组件
这层映射关系是公众号排版的核心。
因为公众号不认识 Markdown,所以 Skill 必须先理解文章语义,再把语义交给主题组件渲染。
同一个「引用」,在简约主题里可以是浅灰底小字块,在红色主题里可以是强调边栏,在绿色主题里可以是更安静的注释卡片。
但它们本质上仍然是引用。
同一个「章节标题」,在不同主题里可以有不同字号、数字、间距和强调色。
但它们本质上仍然是章节标题。
组件化的价值就在这里。
它让主题可以变化,但文章结构不乱。
它让样式可以迭代,但主流程不用重写。
它也让 Agent 更容易判断:当前这一段 Markdown,到底应该交给哪个组件。
「能跑只是起点,能继续改,才说明结构真的站住了。」
09 验收别只看能跑,要看能不能继续改
一个 Skill 第一次跑通,通常不难。
难的是改过几轮之后,它还敢不敢继续改。
公众号排版这种东西尤其明显。今天调标题,明天调引用,后天调图片边距,再过两天又要新增主题。每一次看起来都是小改,但都可能影响整篇文章的最终效果。
所以验收不能只看「生成成功」。

我们要分四层看。
第一层是 contract。
它说明这个 Skill 的输入是什么,输出是什么,边界是什么,哪些能力明确支持,哪些能力明确不支持。
第二层是 lint。
它检查主题和组件文件的结构是否完整,脚本路径是否存在,必需字段有没有漏。
第三层是 regression。
它拿固定压力样稿跑一遍,确认旧问题没有回来。
第四层是预览。
因为排版最终是视觉产品,脚本能检查结构,但看不出某个标题是不是太重,某个引言是不是离正文太远。
这四层合起来,才会让一个 Skill 从「能跑」变成「敢改」。
10 写在最后:好的 Skill 是给下一次扩展留路
很多人把 Skill 理解成「给 Agent 的提示词」。
但一旦它开始承接真实流程,它就更像一个小型产品。
公众号排版这个案例里,它要处理输入,要选择主题,要做 Markdown 到 HTML 的映射,要调用脚本,要检查结果,还要和公众号草稿同步保持边界。
这不是一句提示词能长期撑住的。
好的 Skill,一定要给下一次扩展留路。
今天是公众号排版,明天可能是小红书图文排版,后天可能是长文自动配图,再后面可能是多平台同步。
只要结构清楚,这些能力就可以一层一层长出来。
但如果一开始就把所有东西都塞进一个巨大的 SKILL.md,后面每加一个功能,都是在给自己加债。
所以我现在写 Skill,会反复问自己三个问题:
第一,这个 Skill 的入口和边界清楚吗?
第二,稳定功能有没有脚本化?
第三,未来新增一个主题或模板时,需不需要改主流程?
如果这三个问题答不上来,我宁愿先慢一点,把结构拆清楚。
因为一个好 Skill 的价值,不只是今天替你省十分钟。
而是三个月后,你还敢继续改它。